近日,基于国内最新研发的SXM2双卡NVLink扩展方案,一款高性能专业计算平台——V100-SXM2-Nvlink双卡64G算力盒子正式发布。该产品在电源供应、水冷散热系统与机箱架构上进行了深度优化,核心集成两块NVIDIA Tesla V100-SXM2-32GB专业计算卡,可面向科学计算、AI推理与训练、高性能计算(HPC)等专业领域,提供高速计算负载。用户只需将其连接至电脑主机,即可获得大显存、高计算密度、高内存带宽的双卡算力解决方案。

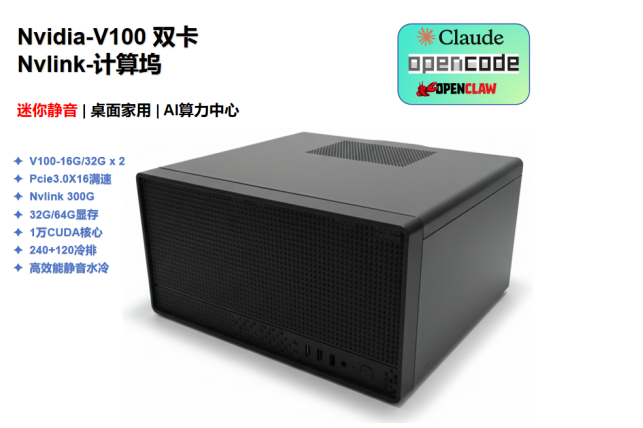
双V100核心,64GB HBM2大显存
据产品资料介绍,该算力盒子集成2块NVIDIA Tesla V100-SXM2-32GB专业计算卡,双卡合计拥有10,240个CUDA核心和1,280个Tensor核心,专为加速科学计算、AI训练与推理、HPC等负载设计。
显存方面,产品配备总计64GB HBM2显存,单卡显存带宽约897–900GB/s,双卡聚合带宽约1800GB/s,显著优于消费级显卡的GDDR6/GDDR6X方案,可有效应对大规模数据集和复杂模型。
官方强调,V100提供领先的FP64双精度和FP16/TF32混合精度计算性能,并支持NVIDIA NVLink高速互连技术,在CAE仿真、计算流体力学、分子动力学、深度学习训练等专业计算领域,性能和价值远高于GeForce RTX 3090/4090等消费级旗舰显卡。后者主要优化单精度和游戏性能,且缺乏原生高速多卡互连能力。
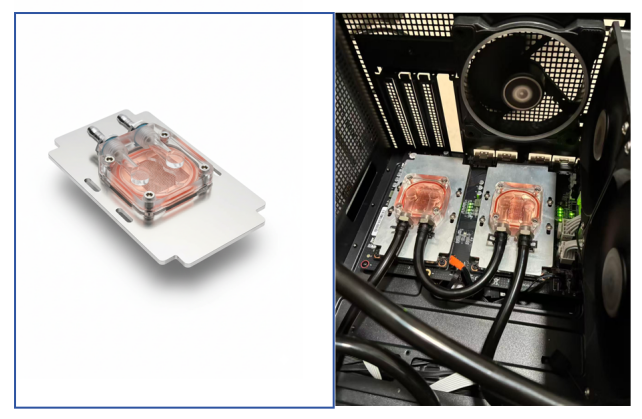

(专利设计Nvidia V100-SXM2水冷头)
NVLink 2.0加持,双卡带宽达300GB/s
该产品通过创新设计绕过传统PCIe通道限制:
· 利用PEX8749交换芯片,将主机的一条PCIe 3.0 x16插槽逻辑拆分为两条独立的PCIe 3.0 x16通道,分别连接两块V100显卡;
· 两块V100显卡之间通过专用6通道NVLink 2.0桥接器直接高速互连,提供高达300GB/s的双向总带宽;
· 这一设计使双卡数据交换速度远超PCIe 3.0 x16约16GB/s的单向带宽,充分发挥V100 NVLink互连性能,显著提升多卡协同计算效率。
性能参数显示,双卡NVLink共12条双向通道,每条通道速率25G/s,单向总速率150GB/s(理论),双向总速率300GB/s(理论)。双卡双向cudaMemcpy可达114.55Gb/s,双卡双向延迟为1.68–1.84μs。
即插即用,灵活扩展至4卡、8卡算力池
产品强调便捷部署与灵活扩展:
· 即插即用:只需将产品附带的转接卡插入主机任意一个PCIe x16插槽,操作系统即可自动识别两块独立的V100显卡,无需额外安装转接卡驱动,部署简便;
· 强大扩展性:得益于独立主机接口设计,产品可接入具备多个PCIe x16插槽的服务器或工作站,满足物理空间和供电要求。用户可灵活部署多组双卡盒子,实现4卡、8卡甚至更大规模的专业算力池构建。
产品规格与性能
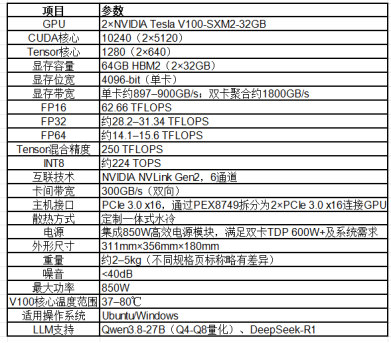

硬件规格清单
· V100-SXM2-32G:2块
· SXM2双卡NVLink 300G扩展板:1块
· 铝合金紫铜水冷头:2个
· 240+120冷排:1套
· 高速水泵:1个
· 850W银牌全模组电源:1个
· M-ATX机箱:1个
扩展底板提供SFF-8654 x16上行、PEX8749交换芯片、GPU1/GPU2插槽、ATX 24Pin、CPU 2×4Pin、GPU 2×4Pin、Auto SW、PS-ON SW等接口,进一步提升部署与维护便利性。
适用场景广泛
该产品适用于多种专业计算场景:
· 人工智能与深度学习:大规模深度学习模型训练,尤其受益于NVLink高速互联和FP16/FP32性能;高性能AI推理(INT8);自然语言处理、计算机视觉研究与应用。
· 高性能计算(HPC):科学计算与仿真(CAE、CFD、FEA,尤其受益于高FP64性能);分子动力学模拟、计算化学、物理模拟;金融建模与风险分析。
· 专业渲染与虚拟化:GPU加速渲染(V-Ray、Redshift、Octane等);VirtualGPU(vGPU)应用,为多个用户提供强大虚拟工作站。
· 数据中心与云计算:构建高密度、高能效的GPU计算节点;提供按需的云端AI/HPC算力服务。
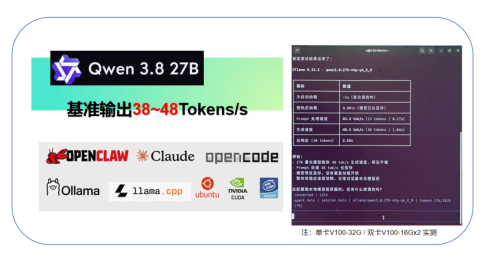

V100-SXM2-Nvlink双卡64G算力盒子的发布,为需要超越消费级显卡、追求专业双精度性能、大显存容量以及多卡高速互联的用户,提供了一种即插即用、模块化、高密度的算力选择。随着AI与HPC需求持续增长,此类双卡算力盒子有望在科研、数据中心、专业渲染和云计算等领域发挥更大价值。更多产品配置与上市信息以官方公布为准。