Qwen2.5-Omni发布:统一多模态理解与生成能力
阿里云正式发布Qwen2.5-Omni,这是一款统一的多模态大模型,能够同时处理文本、图像、音频和视频输入,并生成文本与语音输出。该模型基于Qwen2.5系列架构,在多项基准测试中表现优异,尤其在视觉语言理解和语音识别任务上,性能超越现有开源模型。
Qwen2.5-Omni采用创新的“思考者-讲述者”双通道架构,其中“思考者”负责多模态信息处理与推理,“讲述者”则生成对应的语音响应。该设计支持端到端训练,并实现了低延迟交互体验。模型已开源,开发者可通过Hugging Face等平台获取,并支持多种部署方式。
此次发布进一步巩固了阿里在开源多模态领域的领先地位,为智能助手、实时翻译、无障碍交互等应用场景提供了新选择。
📖 阅读本文共 1,548 次
2026年09月01日 07:10
📱 长按识别 分享给好友~
热门推荐
-

中国电信开源Xing4.0-29B-A4B:全栈国产,一张3090即可本地跑
-

APUS开源国内首批Jev跨平台复现,本地模型实现秒级决策
-

阶跃星辰发布Step 5 Preview:单任务成本仅为Opus 5的1/8
-

ScrollEd把教科书变成TikTok式信息流 学生夫妻创业团队亮相TechCrunch Disrupt
-

剪映发布剪映Hub:打通AI视频生成与多轨道剪辑,PC端手机端同步升级
-
华为首发企业AI白皮书:从单点提效到企业智能化需跨越能力建设与流程连接
-

四川发布就业促进“十五五”规划:城镇新增就业累计425万人以上
-
TechCrunch Disrupt 2026门票优惠倒计时6天,最高可省200美元
-
世界模型公司集体“守口如瓶”:资金与热度齐飞,产品细节成谜
-

必和必拓与中国宝武续签五年备忘录 深化钢铁脱碳合作
分享本文
长按识别二维码
相关文章

中国电信开源Xing4.0-29B-A4B:全栈国产,一张3090即可本地跑
APUS开源国内首批Jev跨平台复现,本地模型实现秒级决策

阶跃星辰发布Step 5 Preview:单任务成本仅为Opus 5的1/8
ScrollEd把教科书变成TikTok式信息流 学生夫妻创业团队亮相TechCrunch Disrupt

剪映发布剪映Hub:打通AI视频生成与多轨道剪辑,PC端手机端同步升级

华为首发企业AI白皮书:从单点提效到企业智能化需跨越能力建设与流程连接

四川发布就业促进“十五五”规划:城镇新增就业累计425万人以上
TechCrunch Disrupt 2026门票优惠倒计时6天,最高可省200美元
国际大屏
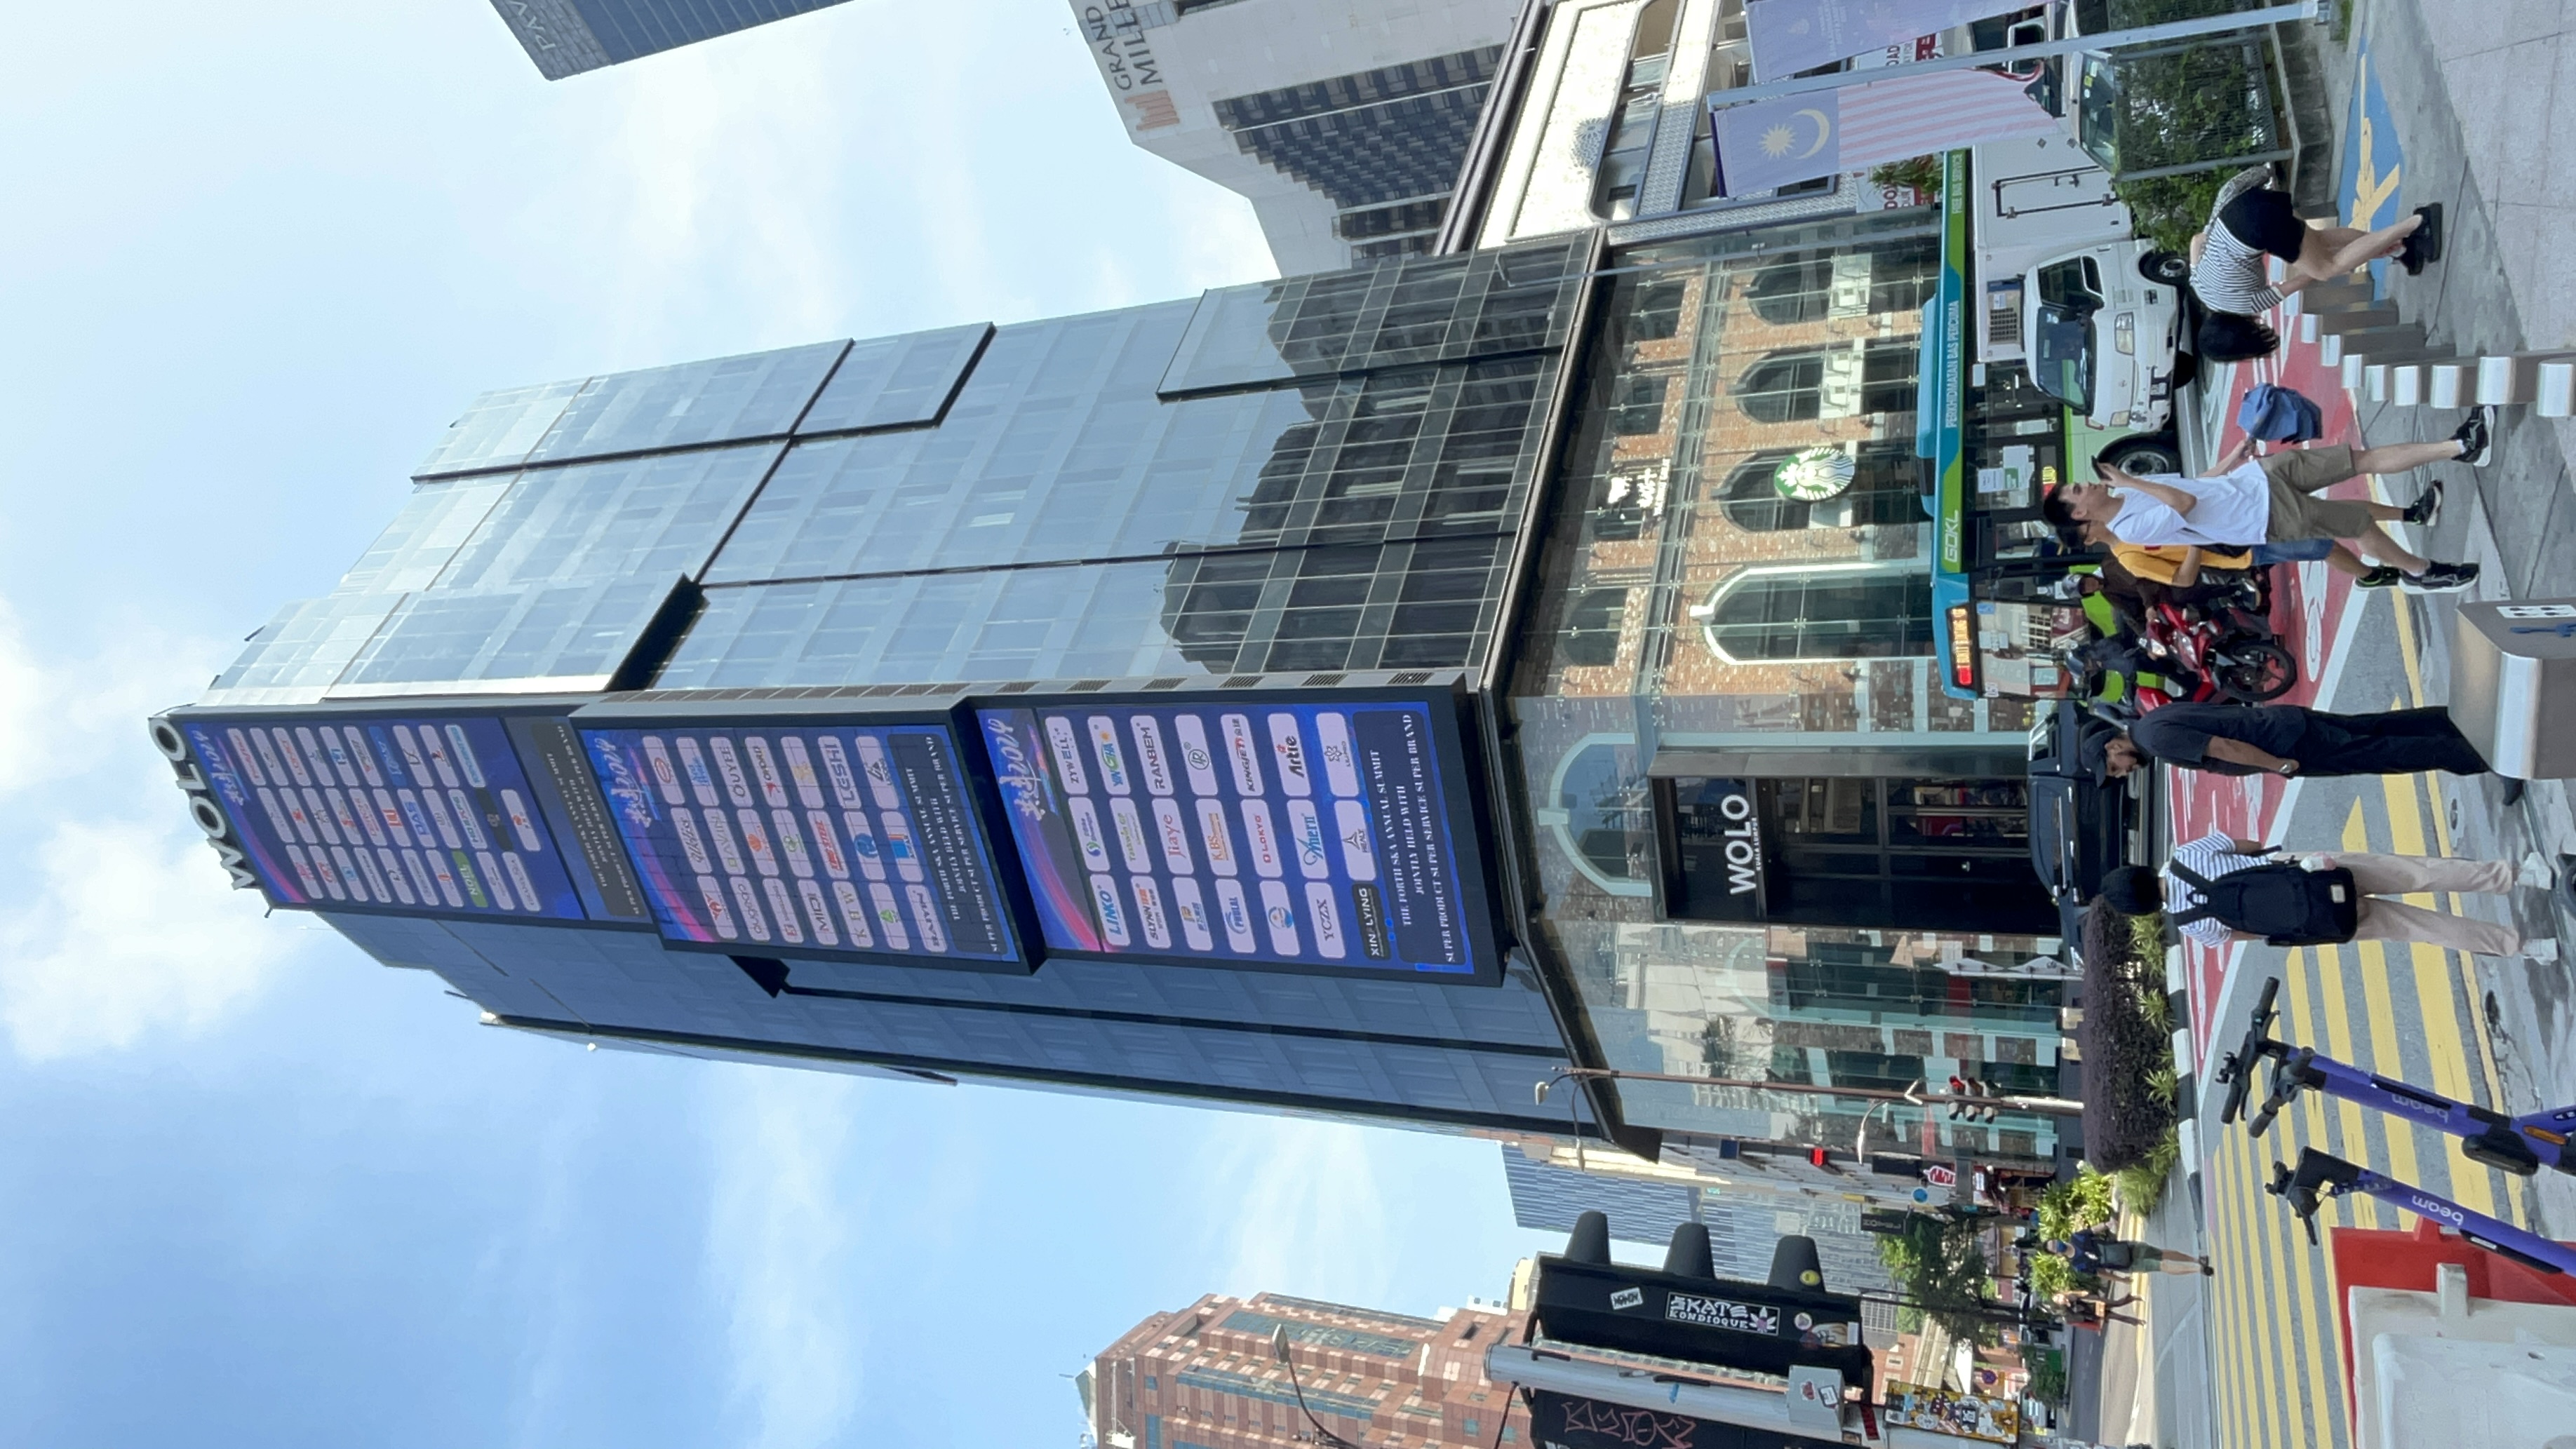
马来西亚吉隆坡WOLO酒店户外WOLO大屏
马来西亚吉隆坡
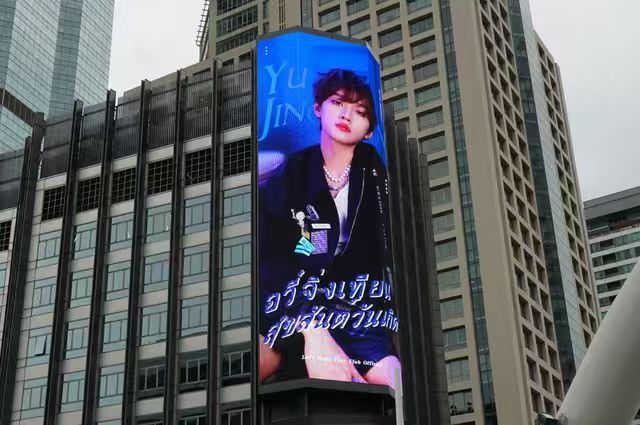
泰国曼谷-帝国大厦-外屏
泰国曼谷

美国纽约时代广场百老汇1619号楼顶屏
美国纽约
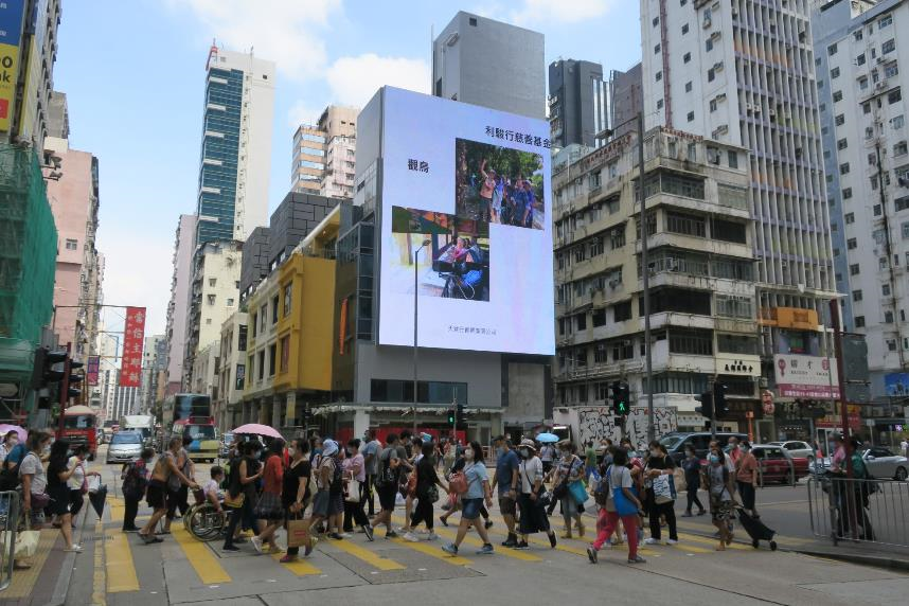
香港旺角亚皆大屏
中国香港

北京大兴机场首都机场电子广告屏
中国北京

加拿大多伦多登打士户外四屏塔 多伦多户外商场大屏
加拿大

新加坡WILKIE EDGE大厦大屏
新加坡

美国纽约时代广场pele大屏above pele store
美国纽约

马来西亚吉隆坡贾兰因比户外大屏
马来西亚
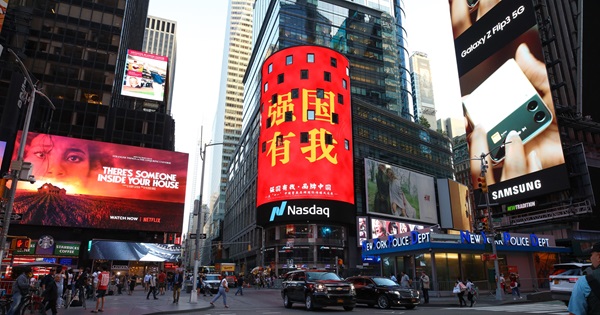
纳斯达克大屏(美国纽约时代广场)
美国纽约

英国伦敦韦斯菲尔德购物广场Westlifed弧形大屏
英国

韩国首尔NB大屏首尔江南区户外大屏
韩国

意大利米兰加里波第车站
意大利
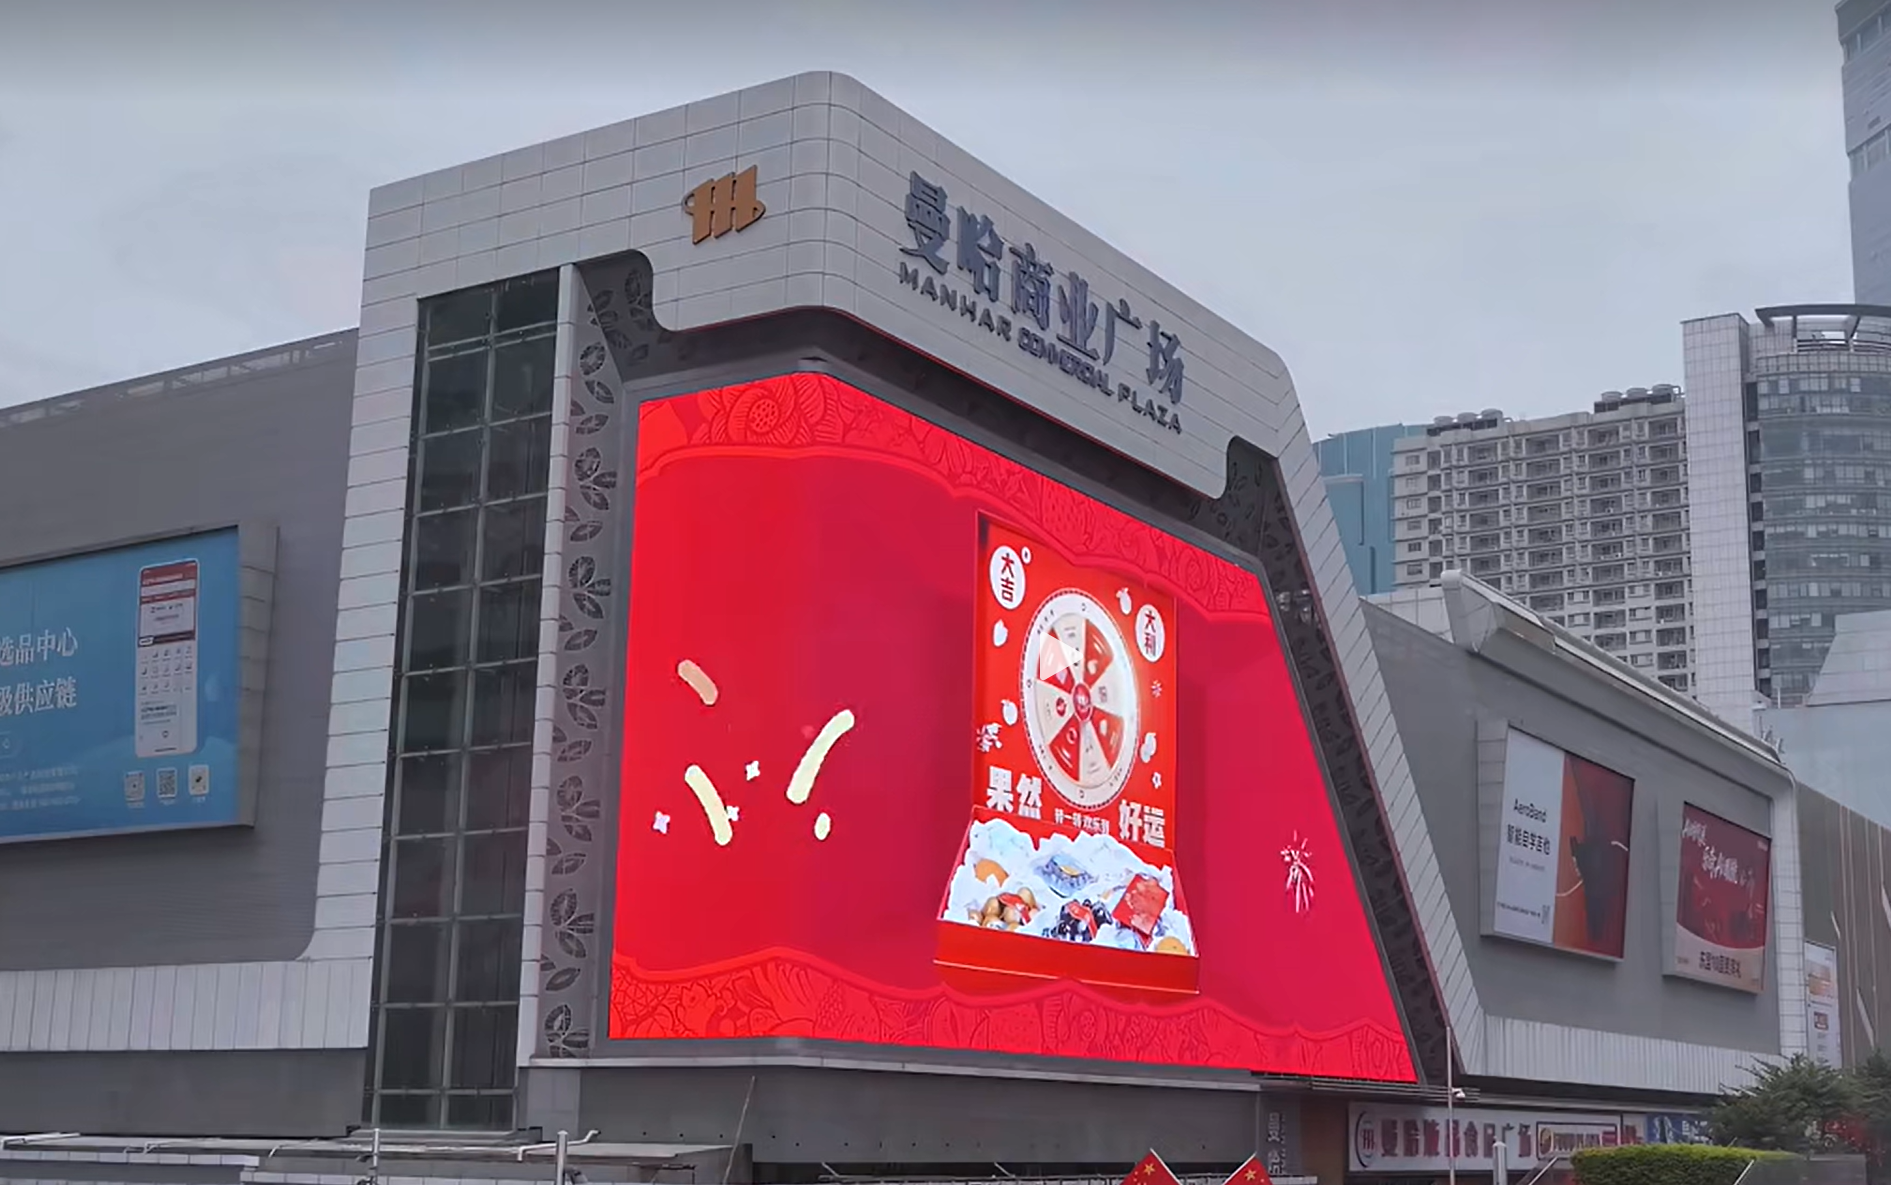
深圳华强北曼哈商业广场3D裸眼大屏
中国深圳

纽约时代广场其他大屏资源
美国纽约

扫码查看视频号
 咨询
咨询